 گجت نیوز آخرین اخبار تکنولوژی، علم و خودرو


از همآواها تا نیمفاصله؛ شش دلیلی که کار هوش مصنوعی را با زبان فارسی سخت میکند.
کلمه «صد» را بلند بگویید. حالا «سد» را. تفاوتی شنیدید؟ احتمالاً نه ، این دو در فارسی دقیقاً یک تلفظ دارند و فقط املایشان فرق میکند.
شما از ادامه جمله میفهمید منظور عدد صد است یا سدی روی رودخانه. مدل تشخیص گفتار هم باید همین کار را بکند، با یک تفاوت مهم: هیچ سرنخ صوتی در اختیار ندارد. باید فقط از روی معنای جمله حدس بزند کدام املا درست است.
این یکی از دهها نقطهای است که تشخیص گفتار فارسی را از انگلیسی سختتر میکند. در سالهای اخیر کیفیت تبدیل گفتار به متن در فارسی جهش بزرگی داشته، اما هر کسی که جدی از این ابزارها استفاده کرده باشد میداند خروجی هنوز بینقص نیست. سؤال جالب این است: چرا؟
پاسخ، یک چیز واحد نیست. مجموعهای از ویژگیهای زبان فارسی و شرایط فنی است که روی هم جمع میشوند.
۱. کلمههایی که یکجور شنیده میشوند و دوجور نوشته
فارسی چند حرف دارد که صدای یکسانی تولید میکنند: «ز»، «ذ»، «ض» و «ظ» همگی /z/ خوانده میشوند؛ «س»، «ص» و «ث» همگی /s/؛ «ت» و «ط»؛ «ه» و «ح»؛ «غ» و «ق». این ویژگی که میراث ورود واژگان عربی به فارسی است، تعداد غیرمعمولی همآوا میسازد:
«صد» و «سد»، «حیاط» و «حیات»، «خوار» و «خار»، «اساس» و «اثاث»، «قوری» و «غوری».
برای هیچکدام از این جفتها موج صوت تفاوتی ندارد؛ مدل باید صرفاً از روی بافت تصمیم بگیرد. بیشتر «غلطهای املایی» که کاربران در خروجی ابزارهای فارسی میبینند، دقیقاً از همینجا میآید.
بدترین حالت، اسمهای خاص است. در جمله «با آقای صادقی صحبت کردم»، معنای جمله هیچ کمکی نمیکند که بفهمیم فامیلی مورد نظر با «ص» نوشته میشود یا «س». اینجا مدل چارهای جز حدس زدن ندارد.
۲. فاصله میان آنچه میگوییم و آنچه مینویسیم
در فارسی، فاصله گفتار محاورهای و نوشتار رسمی قابلتوجه است. «میخواهم بروم» در گفتار روزمره میشود «میخوام برم»؛ «است» حذف میشود، ضمیرها به فعل میچسبند و «را» تبدیل به «رو» میشود.
مدل باید کدام را بنویسد؟ اگر کاربر جلسهای دوستانه را ضبط میکند، نوشتن «میخواهم بروم» ترجمهای از حرف اوست، نه رونوشت آن. اما اگر همان کاربر در حال دیکته کردن نامهای اداری باشد، نوشتن «میخوام برم» خروجی را بیمصرف میکند. این یک مسئله فنی نیست، یک تصمیم طراحی است.
۳. نیمفاصله؛ کاراکتری که همه جور مینویسندش
«میروم»، «میروم»، «می روم». هر سه شکل در متون فارسی دیده میشوند و فقط شکل اول مطابق رسمالخط معیار فرهنگستان است. همین تنوع در دادههایی که مدل با آنها آموزش دیده هم وجود دارد.
نتیجه این است که مدل گاهی خروجی ناهماهنگ تولید میکند: یک جا «خانهها» و چند خط پایینتر «خانه ها». برای متنی که قرار است تحویل استاد، مشتری یا دادگاه شود، این ناهماهنگی یعنی یک دور ویرایش دستی اضافه.
۴. وسط جمله فارسی، انگلیسی حرف میزنیم
به این جمله دقت کنید: «فایل رو download کن و بعد توی فولدر مربوطه paste کن.»
این الگو — که زبانشناسان به آن کدگردانی میگویند — در فارسی تخصصی تقریباً قاعده است، نه استثنا. پزشک نام دارو را انگلیسی میگوید، برنامهنویس نام کتابخانه را و وکیل گاهی اصطلاح عربی را.
برای مدل، این یعنی باید وسط یک جریان صوتی فارسی ناگهان تشخیص دهد که این چند هجا متعلق به زبان دیگری است و باید با الفبای دیگری نوشته شود. ابزارهایی که فقط روی یک زبان تنظیم شدهاند معمولاً اینجا شکست میخورند و کلمه انگلیسی را به نزدیکترین واژه فارسی تبدیل میکنند — با نتایجی که گاهی خندهدار است.
۵. فارسی هنوز یک «زبان کمداده» است
مدلهای تشخیص گفتار با حجم عظیمی از صوت برچسبخورده آموزش میبینند. برای انگلیسی این داده به وفور موجود است: پادکست، فیلم با زیرنویس، آرشیو خبری، مجموعههای متنباز. برای فارسی بهمراتب کمتراست، چیزی که در ادبیات فنی به آن «زبان کممنبع» میگویند.
نتیجهاش را در جاهای مشخصی میبینید: مدل روی گفتار رسمی و شمرده خوب کار میکند، اما هرچه به لهجههای منطقهای، گفتار سریع یا حوزههای تخصصی نزدیکتر میشوید، دقت افت میکند.
۶. دو مسئله که شبیه هم به نظر میرسند، ولی نیستند
این نکتهای است که بیشتر کاربران از آن بیخبرند: «تایپ کردن با صدا» و «تبدیل یک فایل ضبطشده به متن» از نظر فنی دو مسئله متفاوتاند.
در حالت زنده، مدل باید در لحظه تصمیم بگیرد. وقتی کلمهای را میگویید، مدل هنوز نمیداند جمله چطور تمام میشود، پس نمیتواند از ادامه جمله برای رفع ابهام همآواها کمک بگیرد. محدودیت اصلی اینجا تأخیر است: اگر متن با دو ثانیه فاصله روی صفحه بیاید، تجربه کاربری خراب میشود. به همین دلیل بیشتر ابزارهای دیکته زنده ابتدا متنی موقت نشان میدهند و پس از کامل شدن جمله آن را اصلاح میکنند.
در فایل ضبطشده این محدودیت وجود ندارد. کل صوت از پیش موجود است، پس مدل میتواند بافت کامل جمله را ببیند و تصمیم دقیقتری بگیرد. مزیت دوم اینکه فایل را میتوان به بخشهای کوچکتر تقسیم و همزمان پردازش کرد.
یک نمونه ایرانی: آی او تایپ چطور با این چالشها کنار آمده
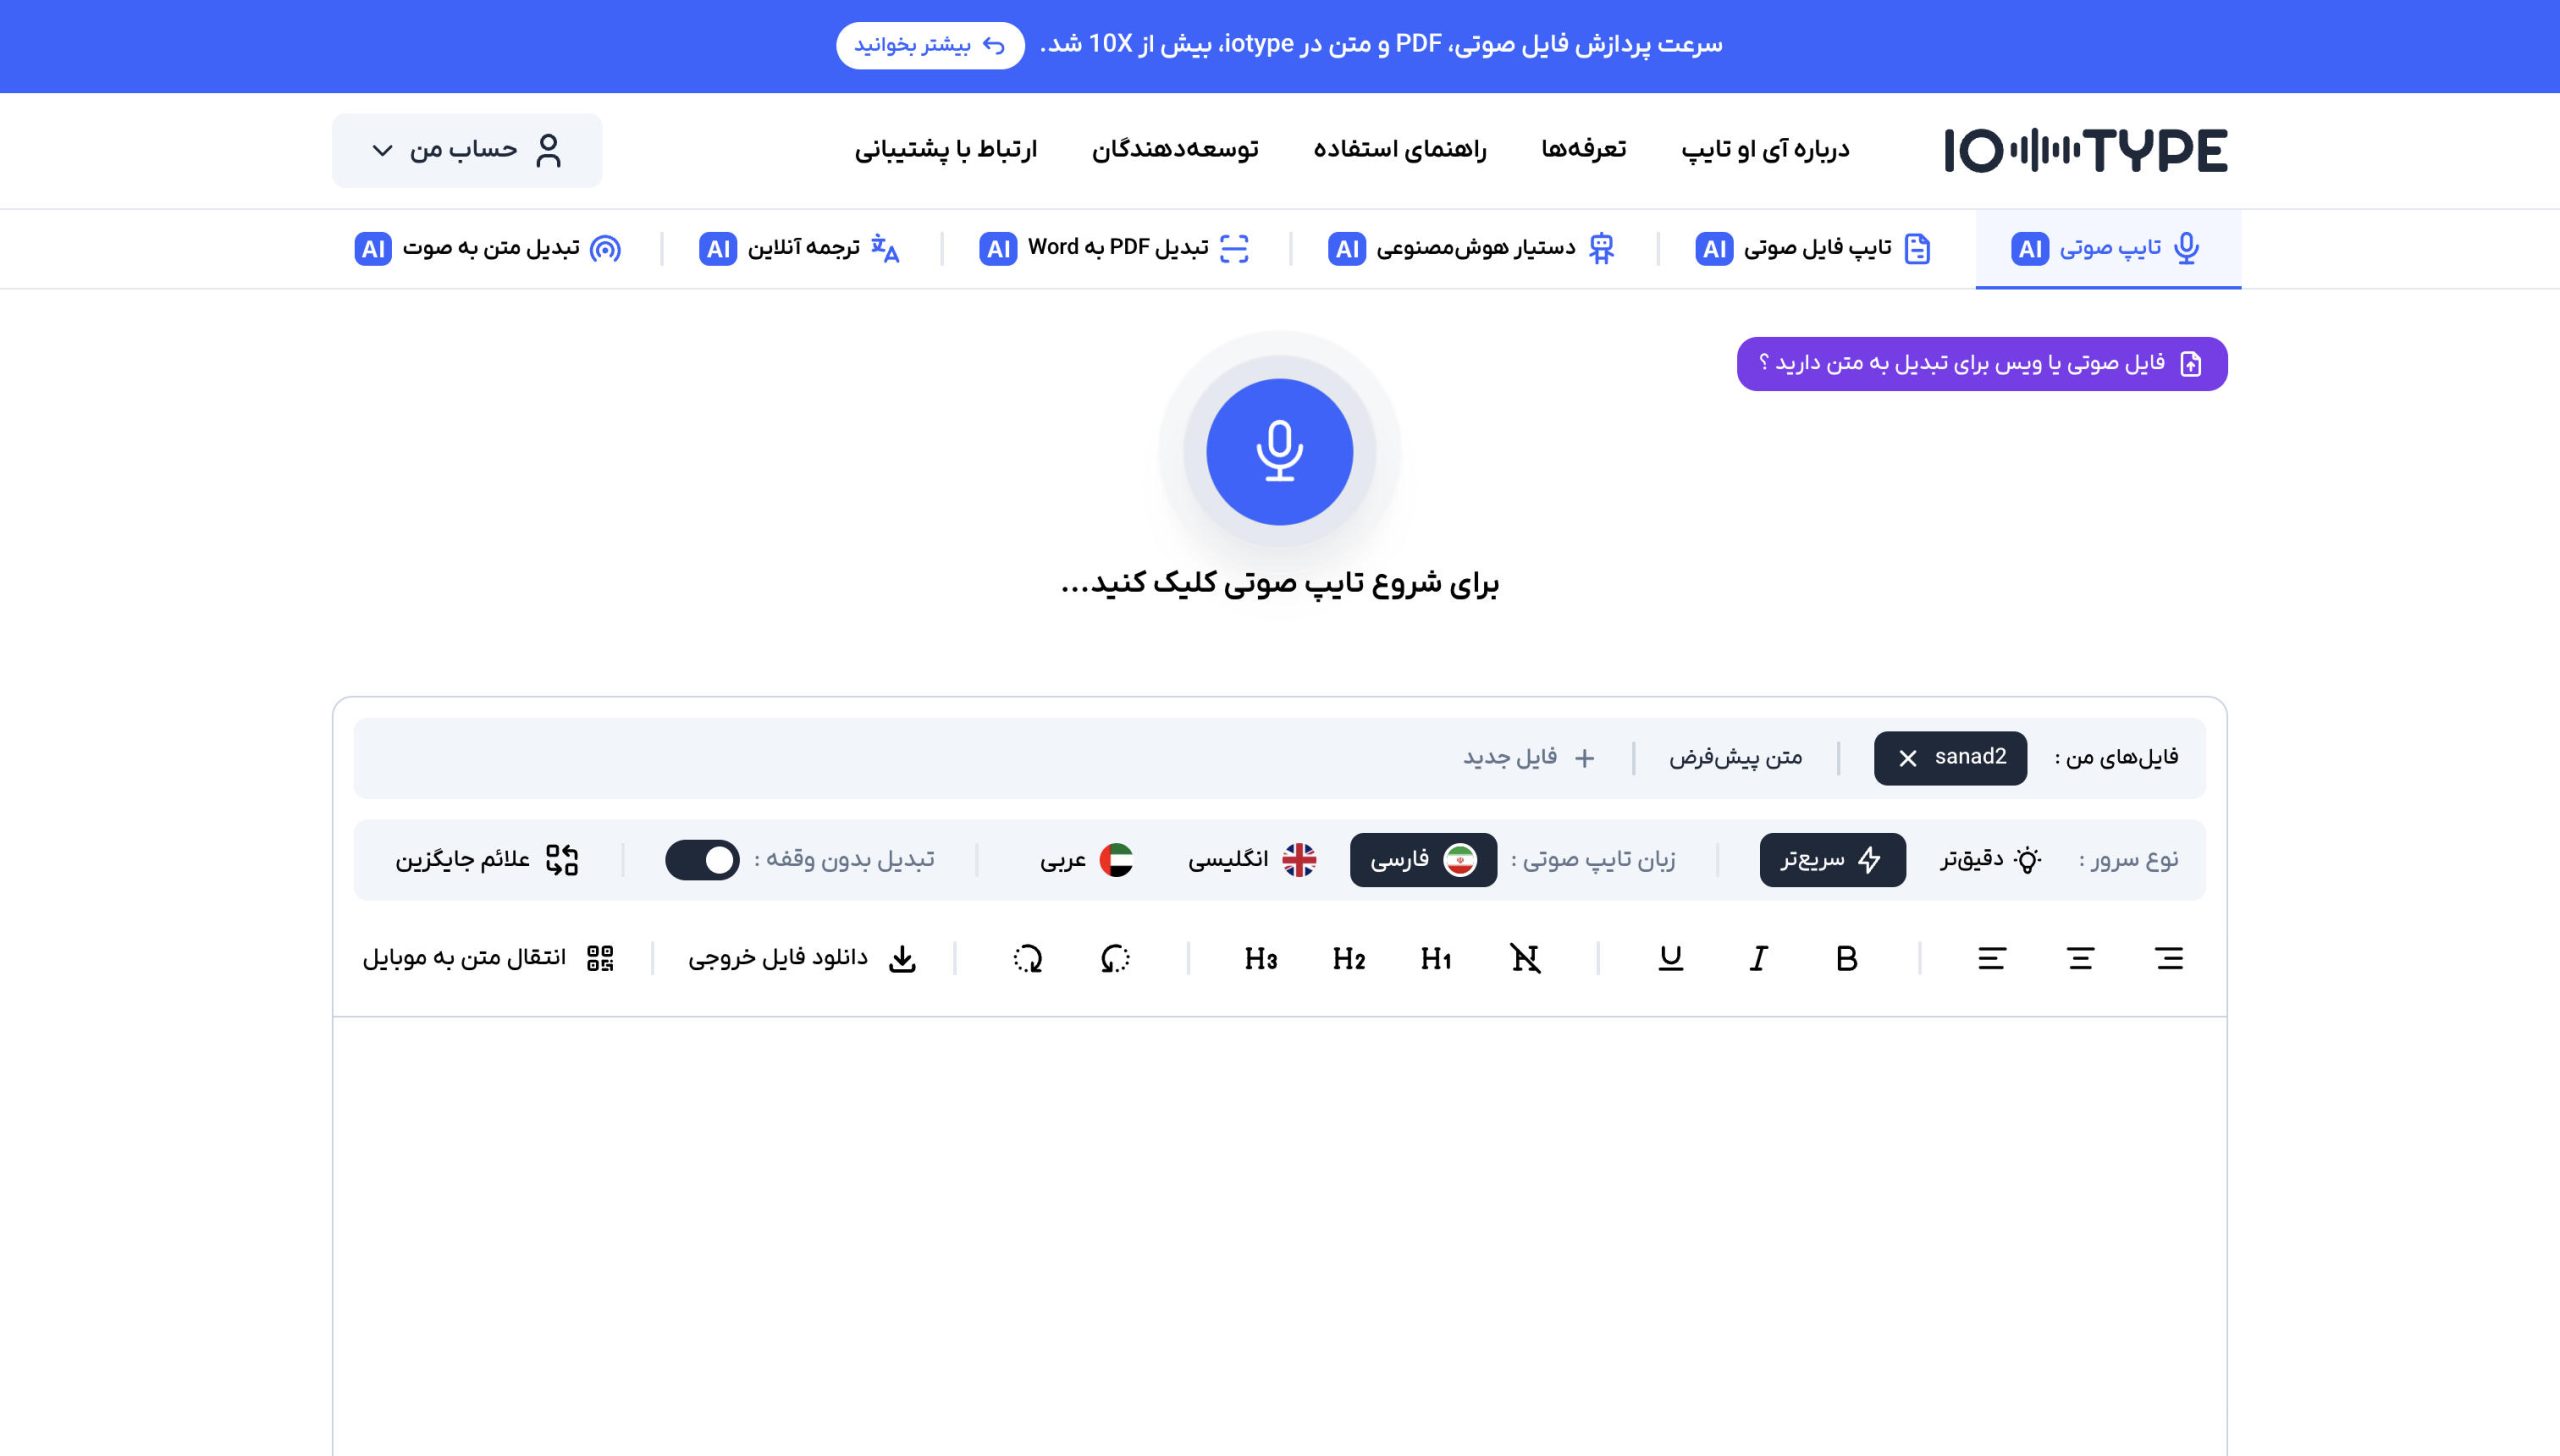
جالب است ببینیم یک سرویس فارسی برای هر کدام از این مسائل چه راهحلی انتخاب کرده. آی او تایپ که از سال ۱۳۹۶ روی تشخیص گفتار فارسی کار میکند، نمونه خوبی است چون تقریباً هر شش مورد بالا جایی در طراحیاش رد پا گذاشتهاند.
برای کدگردانی و واژگان تخصصی، بخشی به نام «علائم و واژگان جایگزین» دارد: کاربر یک بار تعریف میکند که اگر گفت «میکروبشناسی»، نرمافزار microbiology بنویسد. همین سازوکار برای علائم نگارشی هم کار میکند؛ با گفتن «نقطه ویرگول»، علامت «؛» در متن مینشیند. این قابلیت مخصوصاً در متون پزشکی، حقوقی و فنی به کار میآید — جایی که یک اصطلاح بدنوشتهشده میتواند کل سند را بیاعتبار کند.
برای مسئله کممنبع بودن فارسی، روی یادگیری از خود کاربر تکیه میکند. هرچه بیشتر از سرویس استفاده کنید و خطاها را در ویرایشگر اصلاح کنید، تشخیص روی صدا، لهجه و واژگان حوزه شما دقیقتر میشود — یعنی تجربه روز اول و ماه سوم یکسان نیست. سه زبان فارسی، انگلیسی و عربی هم پشتیبانی میشوند.
و یک چالش معکوس: همان ابهامی که در تبدیل صوت به متن از سمت همآواها میآید، در تبدیل متن به صوت از جهت مخالف سر میرسد. چون فارسی صدادارهای کوتاه را نمینویسد، کلمه «مهر» روی کاغذ میتواند «مِهر» باشد یا «مُهر»، و موتور تولید صدا باید پیش از خواندن تصمیم بگیرد کدام است. آی او تایپ برای حل این یکی، یک مرحله اعرابگذاری خودکار به ابتدای مسیر تبدیل متن به صوت اضافه کرده است.
برای تفاوت میان گفتار زنده و فایل ضبطشده، دو مسیر جدا ساخته شده. در سرویس تبدیل فایل صوتی به متن، فایل به بخشهای حدوداً ۱۰ دقیقهای تقسیم و همزمان پردازش میشود. نکته ظریف، انتخاب محل برش است: اگر فایل دقیقاً سر دقیقه دهم بریده شود، احتمال زیادی هست که وسط یک کلمه باشید، پس برش در نزدیکترین پایان جمله انجام میشود.
نتیجه این پردازش موازی فایلهای حجیم این بوده که زمان تبدیل یک فایل ۱۰۰ دقیقهای از ۲۲ دقیقه به ۱ دقیقه و ۵۰ ثانیه رسیده است. این دو عدد در تاریخ ۲۱ مهر ۱۴۰۵ و روی یک فایل یکسان اندازهگیری شدهاند — یک بار با قابلیت پردازش موازی خاموش و یک بار روشن. زمان واقعی برای هر کاربر به ظرفیت همزمان سرور در لحظه بارگذاری هم بستگی دارد.
برای ارزیابی هم لازم نیست هزینهای بدهید: تایپ زنده تا ۲۰۰ کلمه رایگان است که هر ۱۵ دقیقه دوباره شارژ میشود، و برای فایلهای ضبطشده ۵ دقیقه اول رایگان است.
آنچه از دست خود ما برمیآید
بخشی از خطاها به زبان و مدل مربوط است. اما بخش قابلتوجهی ریشه در کیفیت ورودی دارد — و این یکی کاملاً در اختیار ماست:
- میکروفون: هندزفریهای قدیمی بیشترین سهم را در خروجی بد دارند؛ میکروفون داخلی یک لپتاپ معمولی اغلب بهتر است.
- نویز محیط: صدای تلویزیون، مکالمه اطرافیان و کولر، تحلیل فرکانسی را مختل میکنند.
- شمرده حرف زدن: «شمرده» با «آهسته» فرق دارد؛ سرعت طبیعی اما شفاف، بهترین نتیجه را میدهد.
- فاصله و همپوشانی: در ضبط جلسه، نزدیکی دستگاه به گوینده و صحبت نکردن روی حرف هم، از هر تنظیم نرمافزاری مؤثرترند.
فاصلهای که دارد کمتر میشود
ده سال پیش، تبدیل گفتار فارسی به متن بیشتر یک نمایش فنی بود تا ابزار کار. امروز دانشجویی که مصاحبه پایاننامهاش را پیاده میکند و وکیلی که لایحه را با صدا مینویسد، روی همین ابزارها حساب باز کردهاند.
با این حال، تصور «صد در صد دقیق» هنوز واقعبینانه نیست. فارسی زبانی است که دهها جفت همآوا دارد، گفتار و نوشتارش فاصله دارد، رسمالخط یکدستی ندارد و مدام با انگلیسی قاطی میشود. هر کدام از اینها بهتنهایی یک مسئله حلنشده در پردازش زبان طبیعی است.
واقعبینانهترین نگاه این است: ابزارهایی مانند تایپ صوتی آی او تایپ بخش مکانیکی و خستهکننده کار را حذف میکنند، نه مرحله بازبینی را. یک بازخوانی دهدقیقهای روی متنی که ماشین در دو دقیقه آماده کرده، هنوز هم بهمراتب کمهزینهتر از سه ساعت تایپ دستی است.