 گجت نیوز آخرین اخبار تکنولوژی، علم و خودرو

هوش مصنوعی کلود (Claude) در یک پژوهش ۱۶ ساعته که معمولاً توسط انسان انجام میشود، با تکمیل وظایف در کمتر از سه ساعت، کارایی خیرهکنندهای از خود نشان داد.
طبق گزارشی از سازمان پژوهش هوش مصنوعی اپاک، مدلهای زبان بزرگ آنتروپیک عملکردی مشابه یا بهتر از پیمانکاران حرفهای ارائه داده و افقهای جدیدی را در اتوماسیون پژوهش گشودهاند.
پیشرفت چشمگیر هوش مصنوعی کلود در پژوهش
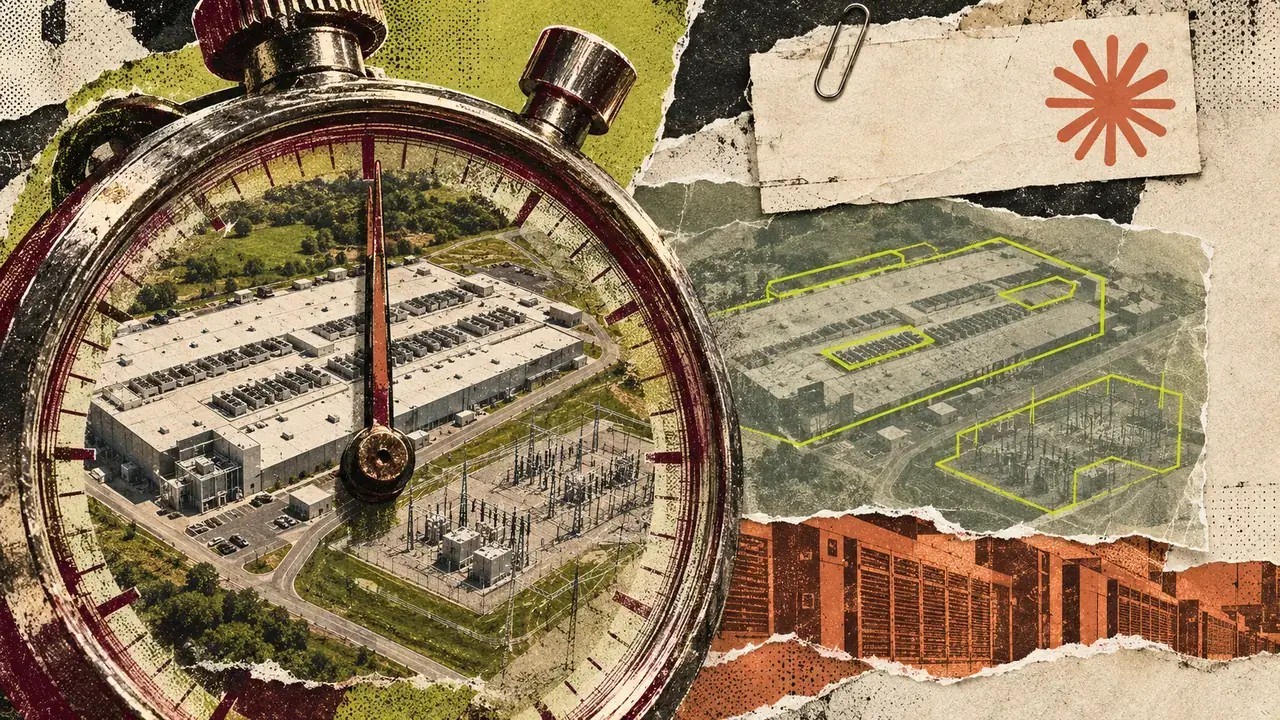
اپاک برای ارزیابی هوش مصنوعی، وظیفه پژوهش درباره مرکز داده «اکودیتاسنتر ۱» را به مدلهای کلود سپرد. مدل کلود اوپوس ۵.۵ (Claude Opus 5.5) این پژوهش را که شامل بررسی گزارشها، اسناد و تصاویر ماهوارهای بود، در کمتر از سه ساعت با امتیاز ۸۷.۵ درصد به اتمام رساند. این عملکرد هم از نظر زمان و هم هزینه، کارآمدتر از پژوهشگر انسانی ۱۶ ساعته بود.
مدل کلود فیبل ۵.۲ (Claude Fable 5.2) نیز با امتیاز ۹۷.۵ درصد و زمان شش و نیم ساعت، عملکرد قابل قبولی داشت. هر دو مدل خروجیهای در حد پژوهشگران حرفهای تولید کردند، اما همچنان به بازنگری در طبقهبندی تجهیزات و حاشیهنویسی تصاویر نیاز داشتند. در مقایسه، GPT-6.2 آسترا (GPT-6.2 Astra) تنها ۶۵ درصد امتیاز کسب کرد که نشاندهنده ضعف آن بود.
تغییر نقش پژوهشگران انسانی در عصر هوش مصنوعی
در پی این نتایج، اپاک قصد دارد در نحوه تخصیص وظایف بین هوش مصنوعی و انسان بازنگری کند. پژوهشگران انسانی اکنون به جای جمعآوری دادهها، بر بررسی خروجیهای هوش مصنوعی، تصحیح خطاها و تحلیلهای تکمیلی تمرکز خواهند کرد. با این حال، گزارش اپاک نشان میدهد که هوش مصنوعی هنوز در تفسیر بصری و برچسبگذاری تصاویر ماهوارهای چالشهایی دارد. از این رو، همکاری میان هوش مصنوعی برای پژوهش اولیه و انسانها برای پالایش و تکمیل آن، سناریوی محتمل آینده خواهد بود.